AI Inference Engine Optimization 2026 Jadi Kunci Mempercepat Pemrosesan AI di Perangkat Modern
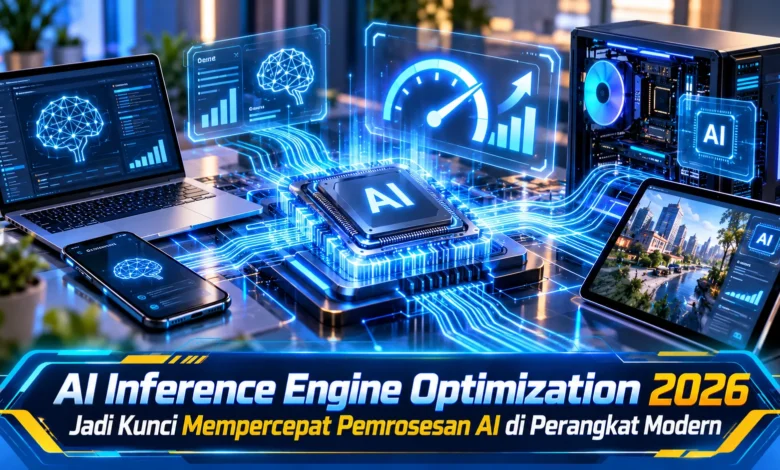
Perkembangan kecerdasan buatan pada 2026 tidak hanya berfokus pada pembuatan model yang semakin canggih, tetapi juga pada bagaimana model tersebut dapat dijalankan secara cepat dan efisien. AI Inference Engine Optimization menjadi bagian penting karena proses inference menentukan seberapa cepat perangkat menghasilkan respons setelah menerima input. Optimalisasi pada tahap ini semakin relevan ketika teknologi AI hadir di smartphone, laptop, kendaraan, perangkat wearable, kamera pintar, hingga berbagai perangkat edge yang membutuhkan respons cepat dengan konsumsi daya tetap terkendali.
Mengenal AI Inference Engine Optimization dan Fungsinya
AI Inference Engine Optimization dapat dipahami sebagai serangkaian teknik untuk membuat proses menjalankan model AI menjadi lebih cepat dan efisien. Sesudah proses pelatihan selesai, model perlu melakukan inference ketika memperoleh data atau permintaan baru. Proses tersebut sangat memengaruhi kecepatan teknologi AI dalam memberikan hasil kepada pengguna.
Optimalisasi inference bukan sekadar usaha untuk membuat pemrosesan berlangsung lebih cepat. Proses optimalisasi juga harus mempertimbangkan kapasitas memori, efisiensi energi, waktu respons, kemampuan perangkat, serta arsitektur hardware. Berbagai aspek tersebut harus diseimbangkan sebab model dengan performa cepat belum tentu sesuai jika konsumsi energi maupun memorinya terlalu tinggi.
Mengapa Kecepatan Inference Semakin Penting pada 2026
Pertumbuhan fitur kecerdasan buatan yang diproses di perangkat membuat performa inference semakin menentukan pengalaman pengguna. Berbagai fitur mulai dari pengolahan visual, penerjemahan, pengenalan audio, pembuatan konten, asisten pintar, hingga analisis sensor membutuhkan pemrosesan yang responsif. Jika proses inference terlalu lambat, pengguna dapat merasakan jeda yang mengurangi kenyamanan ketika berinteraksi dengan perangkat.
Performa inference sangat menentukan sistem yang membutuhkan pengambilan keputusan dalam waktu singkat. Berbagai perangkat dapat menerima data secara kontinu melalui kamera, audio, sensor gerak, serta sumber informasi lainnya. Inference engine yang dioptimalkan membantu memproses informasi tersebut dengan latensi lebih rendah sehingga teknologi dapat memberikan respons secara lebih cepat.
Optimalisasi Presisi Membuat Inference Lebih Efisien
Salah satu pendekatan yang dapat digunakan untuk mengoptimalkan inference adalah quantization. Teknik tersebut bekerja dengan menggunakan representasi angka berpresisi lebih rendah sehingga penggunaan memori maupun beban komputasi dapat ditekan. Jika diterapkan secara tepat, model dapat memiliki ukuran dan kebutuhan komputasi lebih rendah sambil tetap mempertahankan fungsi yang diperlukan.
Meski menawarkan keuntungan, penurunan presisi tetap harus diuji sebab optimalisasi berlebihan berpotensi memengaruhi akurasi maupun kualitas keluaran. Optimalisasi perlu mempertimbangkan kompromi antara ukuran model, waktu pemrosesan, kebutuhan energi, dan kualitas hasil. Oleh sebab itu, evaluasi langsung pada hardware tujuan menjadi tahapan penting sebelum teknologi diterapkan lebih luas.

Hardware Accelerator Membantu Mempercepat Eksekusi AI
Optimalisasi software akan semakin efektif apabila dapat memanfaatkan kemampuan hardware secara tepat. Perangkat modern dapat memiliki CPU, GPU, NPU, maupun akselerator khusus yang memiliki karakteristik berbeda dalam menjalankan beban kerja AI. Mesin inference perlu mengatur pembagian operasi sehingga komponen hardware dapat digunakan secara efektif.
NPU memperoleh perhatian karena komponen tersebut dirancang untuk memproses sejumlah beban kerja AI dengan penggunaan sumber daya yang efisien. Meski demikian, kinerja keseluruhan masih dipengaruhi model, mesin inference, driver, compiler, sistem memori, serta integrasi setiap komponen. Inilah alasan optimalisasi teknologi AI membutuhkan pendekatan lintas software dan hardware, bukan sekadar mengandalkan satu komponen dengan spesifikasi tinggi.
Inference Engine Efisien Mendukung Pertumbuhan On Device AI
On device AI dapat memberikan keuntungan berupa waktu respons singkat serta mengurangi ketergantungan pada layanan cloud dalam tugas tertentu. Meski demikian, smartphone, laptop, perangkat wearable, dan sistem edge tetap memiliki batas energi serta pengelolaan temperatur. Proses inference yang membutuhkan sumber daya besar dapat menguras baterai dan meningkatkan temperatur perangkat sehingga kenyamanan berkurang.
Optimalisasi inference engine bertujuan menekan beban komputasi yang tidak diperlukan sambil menggunakan hardware secara lebih efektif. Berbagai teknik mulai dari manajemen memori, graph optimization, operator fusion, quantization, hingga penjadwalan workload dapat digunakan untuk meningkatkan efisiensi. Hasil yang diharapkan adalah teknologi AI yang mampu memberikan respons cepat tanpa menghabiskan sumber daya perangkat secara berlebihan.
Software dan Model Menentukan Efisiensi Pemrosesan AI
Performa AI tidak semata mata bergantung pada kemampuan prosesor perangkat. Arsitektur model, operasi komputasi, jumlah parameter, format numerik, manajemen memori, compiler, serta runtime ikut menentukan kinerja inference. Karena itu, optimalisasi yang efektif biasanya mempertimbangkan keseluruhan jalur pemrosesan dari model hingga hardware.
Pengembang dapat menyesuaikan model berdasarkan karakteristik perangkat yang menjadi target penggunaan. Model yang ditujukan untuk server dengan sumber daya besar mungkin membutuhkan konfigurasi berbeda dibandingkan model yang berjalan pada smartphone atau wearable. Optimalisasi berdasarkan target hardware dapat membantu menghasilkan keseimbangan antara kualitas model, kecepatan inference, efisiensi energi, dan penggunaan memori.
Kesimpulan
Perkembangan AI Inference Engine Optimization 2026 menunjukkan bahwa model canggih tetap membutuhkan sistem eksekusi yang efisien agar dapat memberikan pengalaman terbaik. Pendekatan melalui quantization, manajemen memori, graph optimization, operator fusion, compiler, runtime, serta pemanfaatan hardware khusus dapat meningkatkan efisiensi pemrosesan. Peran inference yang efisien semakin besar ketika teknologi kecerdasan buatan hadir langsung di smartphone, komputer, wearable, kendaraan, serta berbagai perangkat edge. Dengan mengoptimalkan model, perangkat lunak, dan hardware secara menyeluruh, teknologi AI dapat menghasilkan performa lebih cepat dengan konsumsi sumber daya yang lebih terkendali. Pembaca dapat terus mengikuti perkembangan teknologi inference berikutnya dan mengamati bagaimana optimalisasi ini memengaruhi kemampuan AI pada perangkat yang digunakan sehari hari.


