Local LLM Runtime Makin Populer di 2026, AI Kini Bisa Berjalan Cepat Tanpa Bergantung pada Cloud
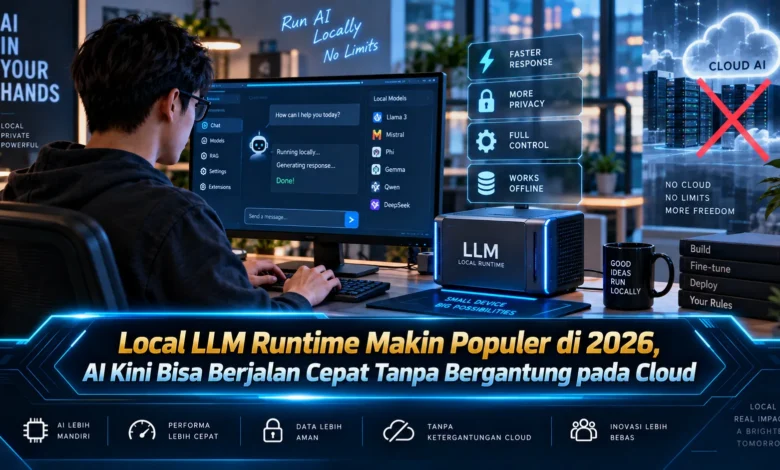
Perkembangan kecerdasan buatan pada 2026 semakin menarik dengan meningkatnya penggunaan Local LLM Runtime, yaitu pendekatan yang memungkinkan model bahasa dijalankan langsung pada komputer, laptop, workstation, atau perangkat lokal tanpa harus selalu mengirim proses ke server cloud. Kemajuan perangkat keras dan optimasi model membuat TEKNOLOGI AI lokal semakin praktis untuk berbagai kebutuhan, mulai dari menulis, merangkum dokumen, membantu pemrograman, hingga mengolah informasi pribadi dengan kontrol data yang lebih besar.
Local LLM Runtime Membawa Perubahan Besar pada Penggunaan AI
Popularitas Local LLM Runtime terus meningkat karena pengguna mulai membutuhkan AI yang dapat bekerja secara cepat tanpa selalu bergantung pada koneksi menuju server eksternal. Melalui pemrosesan di perangkat, permintaan pengguna dapat ditangani langsung oleh sistem lokal tanpa perlu selalu dikirim ke pusat data berbasis internet. Kemajuan ini menjadikan TEKNOLOGI AI lebih mudah disesuaikan karena pengguna dapat menentukan apakah model dijalankan melalui perangkat sendiri atau menggunakan layanan daring.
Pertumbuhan penggunaan AI lokal turut dipengaruhi oleh hadirnya model yang semakin efisien sehingga dapat dijalankan pada perangkat dengan kemampuan komputasi yang lebih beragam. Berbagai teknik optimasi termasuk quantization membuat ukuran dan kebutuhan sumber daya model menjadi lebih ringan sehingga lebih mudah digunakan pada komputer pribadi. Hasilnya, AI lokal tidak lagi hanya menjadi eksperimen bagi pengguna teknis tetapi mulai berkembang menjadi pilihan nyata untuk kebutuhan produktivitas sehari hari.

Kecepatan Menjadi Salah Satu Keunggulan Local LLM Runtime
Salah satu daya tarik Local LLM Runtime adalah kemampuan memberikan respons tanpa harus menunggu perjalanan data dari perangkat menuju server cloud lalu kembali lagi kepada pengguna. Ketika perangkat memiliki prosesor, GPU, NPU, atau memori yang memadai, model dapat menghasilkan respons dengan latensi yang rendah untuk berbagai tugas. Performa sebenarnya tetap dipengaruhi oleh ukuran model, konteks yang diproses, tingkat kompresi, runtime, serta spesifikasi perangkat.
Pemrosesan di perangkat memungkinkan beberapa fungsi AI tetap digunakan ketika jaringan internet mengalami gangguan maupun keterbatasan. Pengguna dapat memproses dokumen, kode, atau informasi lainnya secara lokal selama model dan runtime telah tersimpan di perangkat meskipun akses internet sedang terbatas. Karakteristik tersebut membuat TEKNOLOGI Local LLM menarik bagi pengguna yang mengutamakan fleksibilitas sekaligus ketersediaan sistem AI kapan saja.
Local LLM Memberikan Kontrol Data yang Lebih Besar
Di samping performa, aspek privasi menjadi daya tarik utama karena Local LLM memungkinkan berbagai informasi diproses tanpa selalu meninggalkan perangkat. Dokumen internal, catatan pribadi, kode program, atau informasi lainnya dapat diproses secara lokal apabila sistem dikonfigurasi tanpa mengirimkan data kepada layanan eksternal. Model lokal memberikan pengguna kendali lebih besar dalam menentukan bagaimana informasi diproses serta layanan mana yang memperoleh akses.
Namun penggunaan lokal tidak otomatis membuat seluruh sistem sepenuhnya aman karena keamanan tetap dipengaruhi oleh konfigurasi perangkat, aplikasi, jaringan, model, dan kebiasaan pengguna. Komputer yang terkena malware maupun memiliki pengamanan akun yang lemah masih dapat membuat informasi lokal berada dalam risiko. Itulah mengapa TEKNOLOGI kecerdasan buatan lokal tetap membutuhkan perlindungan melalui pembaruan perangkat, enkripsi, autentikasi, dan pengelolaan izin yang baik.
GPU NPU dan Memori Menjadi Penggerak Local LLM Runtime
Peningkatan kemampuan perangkat keras membuat AI lokal semakin mudah digunakan karena komputer terbaru memiliki sumber daya yang semakin kuat untuk pemrosesan kecerdasan buatan. GPU mampu mempercepat perhitungan model sedangkan NPU memberikan jalur khusus untuk mengolah sebagian tugas AI secara lebih efisien. Ketersediaan memori sistem serta memori grafis sangat memengaruhi model apa yang dapat dijalankan dan seberapa panjang konteks yang bisa diproses.
Perangkat kelas atas bukan satu satunya pilihan karena model berukuran lebih kecil dapat memberikan performa yang cukup baik untuk berbagai tugas sehari hari. Model sebaiknya dipilih berdasarkan spesifikasi komputer dan kebutuhan tugas agar pengguna tidak menjalankan ukuran yang terlalu berat bagi perangkat. Pendekatan tersebut membuat TEKNOLOGI Local LLM semakin inklusif karena pengguna dapat memilih model berdasarkan kemampuan perangkat tanpa harus selalu mengejar ukuran terbesar.
Penggunaan Local LLM Mulai Meluas untuk Pekerjaan Sehari Hari
Local LLM Runtime dapat dimanfaatkan untuk berbagai kebutuhan seperti membuat rangkuman, membantu menulis, membaca dokumen, mencari informasi dalam berkas lokal, maupun memberikan bantuan pemrograman. Bagi pengembang, model lokal dapat diintegrasikan dengan perangkat lunak sehingga fitur AI dapat berjalan langsung di lingkungan pengguna. Hal ini mendorong perkembangan aplikasi yang tidak terlalu bergantung pada layanan jarak jauh sekaligus menawarkan kontrol data yang lebih besar.
Di organisasi, Local LLM dapat mendukung pencarian data internal, penyusunan informasi, maupun otomatisasi pekerjaan selama penggunaan mengikuti kebijakan keamanan. AI dapat dihubungkan dengan data internal atau mekanisme pencarian lokal sehingga jawaban dapat disesuaikan dengan informasi organisasi. Pemanfaatan seperti ini memperlihatkan bagaimana TEKNOLOGI Local LLM dapat berkembang dari sekadar chatbot menjadi komponen produktivitas yang terintegrasi dengan berbagai sistem.
AI Lokal Tidak Sepenuhnya Menggantikan Cloud
Popularitas AI lokal bukan berarti komputasi cloud akan kehilangan fungsinya sebab local runtime dan cloud memiliki karakteristik yang berbeda. Layanan cloud masih unggul ketika dibutuhkan model berukuran besar serta komputasi tinggi sedangkan AI lokal dapat lebih praktis untuk pekerjaan yang membutuhkan privasi, latensi rendah, dan akses offline. Keputusan menggunakan lokal atau cloud dapat disesuaikan dengan karakter tugas, kapasitas hardware, kebutuhan keamanan data, dan faktor biaya.
Pendekatan hybrid bahkan berpotensi menjadi semakin umum ketika tugas sederhana dijalankan secara lokal sedangkan pekerjaan yang membutuhkan kemampuan lebih besar diteruskan ke layanan cloud. Model seperti ini dapat memberikan keseimbangan antara kecepatan, privasi, kemampuan komputasi, dan fleksibilitas penggunaan. Arah tersebut menunjukkan bahwa masa depan TEKNOLOGI AI kemungkinan tidak hanya berpusat pada cloud tetapi juga pada distribusi pemrosesan yang semakin dekat dengan perangkat pengguna.
Kesimpulan AI Semakin Cepat Tanpa Ketergantungan Penuh pada Cloud
Perkembangan Local LLM Runtime menandai tren baru pada 2026 karena model AI mulai dapat digunakan secara praktis dari perangkat lokal tanpa selalu membutuhkan pemrosesan jarak jauh. Manfaat berupa respons cepat, penggunaan offline, kendali terhadap data, dan pilihan model yang fleksibel membuat AI lokal semakin relevan untuk pengguna serta developer. Peningkatan kemampuan hardware dan efisiensi model membantu membawa Local LLM menuju lebih banyak jenis komputer serta skenario penggunaan. Seiring kemajuan TEKNOLOGI, Local LLM berpotensi menjadi komponen penting dalam masa depan AI dengan memberikan pilihan antara pemrosesan lokal, cloud, maupun kombinasi keduanya.