Tips Mengoptimalkan GPU untuk AI, Maksimalkan Performa Tanpa Boros VRAM
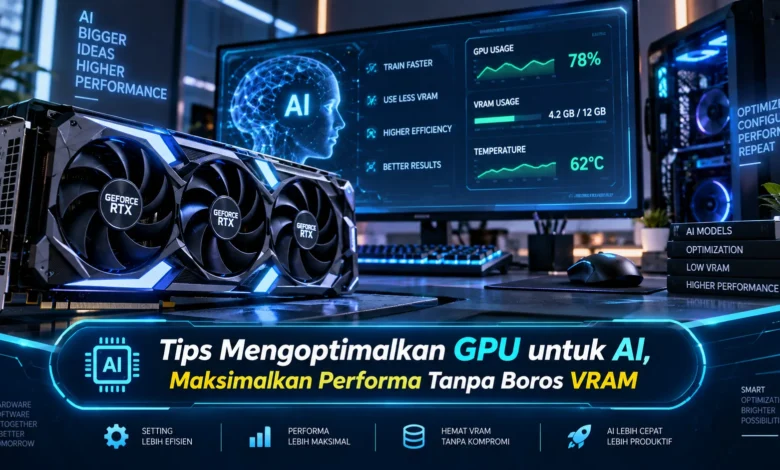
GPU menjadi salah satu komponen terpenting ketika menjalankan workload AI, baik untuk training, fine tuning, inference, maupun eksperimen model lokal. Namun, performa tinggi tidak selalu harus dibayar dengan konsumsi VRAM yang besar. Dengan konfigurasi yang tepat, pengguna dapat meningkatkan efisiensi komputasi sekaligus menjaga penggunaan memori tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI karena model modern terus bertambah kompleks sementara kapasitas perangkat keras tetap memiliki batas tertentu.
Analisis Kebutuhan Memori Sebelum Memulai Workload AI
Hal pertama ketika ingin meningkatkan efisiensi GPU AI adalah memahami kebutuhan VRAM dari model yang digunakan. Model AI berukuran besar umumnya mengonsumsi VRAM dalam jumlah lebih besar, terlebih saat model digunakan untuk proses training. Dengan melakukan estimasi dari awal, pengguna dapat mengatur parameter komputasi secara lebih efisien.
Selain ukuran model, batch size, panjang konteks, resolusi data, dan precision juga memengaruhi penggunaan VRAM. Makin besar jumlah data yang diproses secara bersamaan, semakin banyak VRAM yang dibutuhkan. Oleh sebab itu, pengaturan workload perlu diseimbangkan dengan kapasitas perangkat agar performa TEKNOLOGI AI tetap optimal tanpa menyebabkan kehabisan memori.
Kurangi Konsumsi Memori dengan Mixed Precision
Salah satu metode yang cukup efektif untuk menghemat kapasitas memori grafis ialah memanfaatkan format numerik yang lebih ringan. Format seperti FP16 atau BF16 dapat mengurangi kebutuhan memori dibandingkan FP32, sekaligus mempertahankan kecepatan komputasi yang tinggi pada kartu grafis yang mendukung akselerasi AI.
Mixed precision training turut menjadi pendekatan yang efektif karena sistem dapat menggabungkan perhitungan presisi rendah dan tinggi sesuai kebutuhan. Strategi tersebut mampu meningkatkan jumlah data yang diproses sambil mengurangi beban memori GPU. Pada perkembangan TEKNOLOGI kecerdasan buatan saat ini, penggunaan format numerik yang tepat menjadi kunci untuk mendapatkan efisiensi komputasi yang lebih baik.
Atur Batch Size agar Performa dan Memori Tetap Seimbang
Batch size memiliki pengaruh besar terhadap konsumsi VRAM. Batch yang terlalu besar dapat membebani memori GPU dengan cepat, sementara batch yang terlalu kecil dapat menurunkan efisiensi GPU. Pengaturan yang proporsional sebaiknya ditentukan berdasarkan kapasitas memori dan jenis workload.
Ketika GPU memiliki VRAM terbatas, teknik gradient accumulation dapat membantu mempertahankan efek batch besar tanpa harus memproses seluruh batch dalam satu waktu. Metode ini membagi proses menjadi beberapa langkah kecil, lalu mengakumulasi gradien sebelum optimizer bekerja. Melalui teknik tersebut, pengguna dapat mempertahankan efisiensi training tanpa membutuhkan VRAM yang terlalu besar.
Manfaatkan Quantization untuk Model AI yang Lebih Ringan
Quantization merupakan salah satu pendekatan efektif dalam mengurangi kebutuhan memori ketika menggunakan model besar. Dengan merepresentasikan parameter menggunakan format yang lebih ringkas, misalnya dari 16 bit menjadi 8 bit atau 4 bit, kebutuhan VRAM dapat ditekan dengan cukup besar.
Metode quantization cukup efektif untuk kebutuhan inference maupun penggunaan model bahasa besar di perangkat lokal. Model yang awalnya sulit dimuat karena ukuran memori berpotensi dimuat pada perangkat dengan kapasitas VRAM yang lebih kecil. Meski demikian, pengaturan precision tidak sebaiknya dilakukan secara sembarangan karena pengurangan bit yang terlalu agresif dapat memengaruhi kualitas output.
Hindari VRAM Terbuang karena Cache yang Tidak Digunakan
Beban VRAM bukan hanya berasal dari parameter AI, tetapi juga dari cache, tensor sementara, activation, serta proses lain yang berjalan bersamaan. Dengan demikian, pengguna perlu memantau penggunaan GPU secara berkala untuk memastikan tidak ada proses yang menghabiskan memori secara tidak diperlukan.
Membersihkan cache yang sudah tidak digunakan dapat membantu menyediakan lebih banyak ruang untuk workload berikutnya. Selain itu, menutup aplikasi grafis atau program lain yang menggunakan GPU dapat memberikan lebih banyak ruang memori untuk workload AI. Manajemen seperti ini sering kali memberikan peningkatan stabilitas yang signifikan terutama pada perangkat dengan VRAM terbatas.
Software yang Tepat Membantu GPU AI Bekerja Lebih Efisien
Performa GPU tidak hanya bergantung pada hardware, melainkan sangat dipengaruhi oleh perangkat lunak pendukung, driver, serta framework AI. Versi driver yang kompatibel dapat meningkatkan stabilitas dan kompatibilitas, khususnya saat menjalankan library machine learning modern.
Perangkat lunak AI terkini umumnya menawarkan mekanisme efisiensi komputasi seperti memory efficient attention, fused operation, dan kernel yang lebih optimal. Menggunakan versi software yang sesuai dapat menghasilkan peningkatan performa tanpa harus mengganti GPU. Karena itu, pengaturan software perlu mendapatkan perhatian yang sama seperti spesifikasi GPU.
Penutup
Mengoptimalkan GPU untuk AI bukan hanya soal menggunakan kartu grafis dengan VRAM terbesar. Pemilihan precision, pengaturan batch size, penggunaan quantization, pengelolaan cache, serta optimasi software dapat memberikan peningkatan efisiensi yang signifikan. Dengan strategi yang tepat, workload AI dapat berjalan lebih stabil meski kapasitas VRAM memiliki keterbatasan.
Perkembangan TEKNOLOGI AI terus mendorong hadirnya metode komputasi yang semakin efisien. Dengan demikian, strategi optimasi sebaiknya tidak hanya berpusat pada kekuatan GPU, namun juga memperhatikan pengaturan model, framework, dan penggunaan memori. Dengan menerapkan berbagai pendekatan tersebut, performa AI dapat dimaksimalkan tanpa membuat VRAM terbuang sia sia. Pembaca dapat melakukan pengujian bertahap agar memperoleh keseimbangan terbaik antara kecepatan, penggunaan VRAM, dan kualitas hasil.