Local LLM Runtime Makin Populer di 2026, AI Kini Bisa Berjalan Cepat Tanpa Bergantung pada Cloud
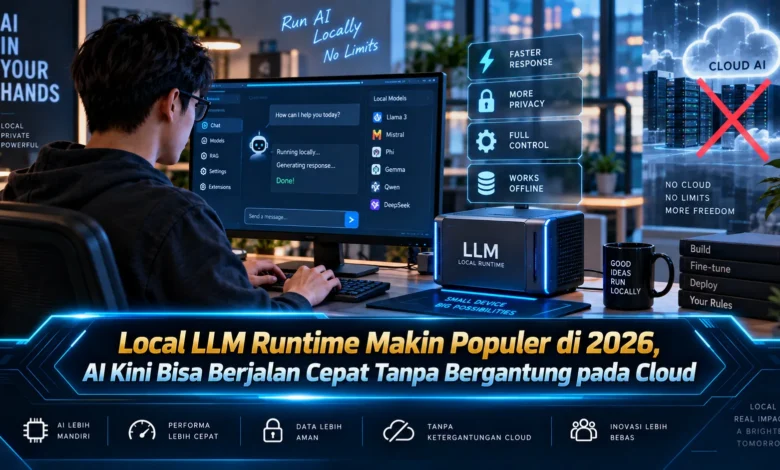
Perkembangan kecerdasan buatan pada 2026 semakin menarik dengan meningkatnya penggunaan Local LLM Runtime, yaitu pendekatan yang memungkinkan model bahasa dijalankan langsung pada komputer, laptop, workstation, atau perangkat lokal tanpa harus selalu mengirim proses ke server cloud. Kemajuan perangkat keras dan optimasi model membuat TEKNOLOGI AI lokal semakin praktis untuk berbagai kebutuhan, mulai dari menulis, merangkum dokumen, membantu pemrograman, hingga mengolah informasi pribadi dengan kontrol data yang lebih besar.
AI Lokal Semakin Populer Berkat Perkembangan Local LLM Runtime
Perkembangan Local LLM Runtime semakin menarik perhatian karena pengguna menginginkan sistem AI yang mampu berjalan langsung tanpa harus terus terhubung dengan layanan cloud. Dengan menjalankan model secara langsung di perangkat, proses permintaan dan respons dapat dilakukan di dalam sistem lokal sehingga sebagian pekerjaan tidak perlu dikirim menuju pusat data jarak jauh. Perubahan ini membuat TEKNOLOGI AI semakin fleksibel karena pengguna memiliki pilihan antara menggunakan layanan cloud atau menjalankan model sesuai kemampuan perangkat yang tersedia.
Pertumbuhan penggunaan AI lokal turut dipengaruhi oleh hadirnya model yang semakin efisien sehingga dapat dijalankan pada perangkat dengan kemampuan komputasi yang lebih beragam. Berbagai teknik optimasi termasuk quantization membuat ukuran dan kebutuhan sumber daya model menjadi lebih ringan sehingga lebih mudah digunakan pada komputer pribadi. Perkembangan tersebut membuat AI lokal mulai berpindah dari lingkungan eksperimen menuju penggunaan praktis dalam aktivitas sehari hari.
Pemrosesan Lokal Mengurangi Ketergantungan terhadap Server Cloud
Salah satu alasan AI lokal terasa responsif adalah karena sebagian proses berlangsung langsung pada perangkat tanpa membutuhkan pengiriman data menuju pusat komputasi jarak jauh. Dengan dukungan perangkat keras yang memadai seperti GPU atau akselerator AI, Local LLM dapat menghasilkan respons secara cepat untuk kebutuhan tertentu. Kecepatan akhirnya bergantung pada ukuran model, panjang konteks, metode quantization, optimasi runtime, dan kemampuan perangkat yang digunakan.
Penggunaan lokal juga dapat memberikan pengalaman yang lebih stabil ketika koneksi internet sedang lambat atau tidak tersedia. Pengguna yang sering bekerja dengan dokumen, kode, maupun catatan dapat menjalankan model tanpa harus bergantung pada kondisi jaringan selama seluruh komponen yang diperlukan sudah tersedia pada perangkat. Karakteristik tersebut membuat TEKNOLOGI Local LLM menarik bagi pengguna yang mengutamakan fleksibilitas sekaligus ketersediaan sistem AI kapan saja.
Local LLM Memberikan Kontrol Data yang Lebih Besar
Di samping performa, aspek privasi menjadi daya tarik utama karena Local LLM memungkinkan berbagai informasi diproses tanpa selalu meninggalkan perangkat. Data berupa dokumen, catatan, dan berbagai informasi sensitif dapat tetap berada pada perangkat ketika seluruh pemrosesan dilakukan secara lokal. Model lokal memberikan pengguna kendali lebih besar dalam menentukan bagaimana informasi diproses serta layanan mana yang memperoleh akses.
Walaupun proses dilakukan secara lokal, keamanan tidak otomatis terjamin karena masih bergantung pada pengaturan sistem, perangkat lunak, jaringan, serta cara pengguna mengelolanya. Perangkat yang terinfeksi malware atau memiliki akses pengguna yang tidak terlindungi tetap dapat membahayakan informasi yang tersimpan secara lokal. Oleh sebab itu penggunaan TEKNOLOGI Local LLM sebaiknya dibarengi praktik keamanan seperti update sistem, enkripsi penyimpanan, kontrol akun, serta pengaturan akses.
Kemajuan Hardware Mempercepat Pertumbuhan Local LLM
Peningkatan kemampuan perangkat keras membuat AI lokal semakin mudah digunakan karena komputer terbaru memiliki sumber daya yang semakin kuat untuk pemrosesan kecerdasan buatan. Keberadaan GPU membantu mempercepat komputasi model sementara NPU mulai digunakan untuk menjalankan beban AI dengan konsumsi sumber daya yang lebih terarah. Jumlah RAM maupun memori GPU menjadi faktor penting sebab model dan konteks perlu ditempatkan dalam memori ketika proses inferensi dilakukan.
Pengguna tidak selalu membutuhkan perangkat kelas tertinggi karena model yang lebih kecil dan teroptimasi dapat memberikan hasil yang memadai untuk berbagai pekerjaan ringan hingga menengah. Menyesuaikan ukuran model dengan kemampuan hardware menjadi langkah penting supaya penggunaan AI lokal tetap cepat dan stabil. Cara ini menjadikan TEKNOLOGI AI lokal lebih mudah diakses karena model dapat disesuaikan dengan kemampuan komputer masing masing.
Local LLM Cocok untuk Produktivitas Coding dan Pengolahan Dokumen
Penggunaan Local LLM dapat mencakup aktivitas seperti meringkas dokumen, menyusun teks, memahami catatan, mencari informasi pada file, dan membantu proses coding. Pengembang juga dapat menghubungkan model dengan aplikasi lokal sehingga AI menjadi bagian dari alur kerja tanpa seluruh informasi harus dikirim menuju layanan eksternal. Kemampuan ini membuka peluang bagi aplikasi yang dapat digunakan secara lebih mandiri sekaligus memiliki kontrol lebih besar terhadap sumber data yang diproses.
Dalam lingkungan perusahaan, Local LLM juga dapat digunakan untuk membantu pencarian dokumen internal, pengelolaan pengetahuan, atau otomatisasi tugas tertentu dengan tetap mempertimbangkan kebijakan keamanan organisasi. AI dapat dihubungkan dengan data internal atau mekanisme pencarian lokal sehingga jawaban dapat disesuaikan dengan informasi organisasi. Pemanfaatan seperti ini memperlihatkan bagaimana TEKNOLOGI Local LLM dapat berkembang dari sekadar chatbot menjadi komponen produktivitas yang terintegrasi dengan berbagai sistem.
AI Lokal Tidak Sepenuhnya Menggantikan Cloud
Popularitas AI lokal bukan berarti komputasi cloud akan kehilangan fungsinya sebab local runtime dan cloud memiliki karakteristik yang berbeda. Pemrosesan cloud tetap relevan bagi model dengan kebutuhan sumber daya besar sementara Local LLM menawarkan keuntungan untuk tugas yang dapat ditangani langsung di perangkat. Pengguna dapat memilih keduanya berdasarkan kompleksitas tugas, sensitivitas informasi, biaya, dan kemampuan hardware yang dimiliki.
Kombinasi lokal dan cloud berpeluang berkembang dengan membagi pekerjaan berdasarkan kebutuhan sumber daya serta tingkat kompleksitas. Model seperti ini dapat memberikan keseimbangan antara kecepatan, privasi, kemampuan komputasi, dan fleksibilitas penggunaan. Perkembangan ini menunjukkan bahwa TEKNOLOGI kecerdasan buatan dapat bergerak menuju pembagian komputasi antara perangkat lokal dan pusat data.
Kesimpulan Local LLM Runtime dan Masa Depan AI Lokal
Local LLM Runtime menunjukkan perubahan penting pada 2026 ketika AI semakin mudah diproses secara langsung melalui perangkat pengguna tanpa ketergantungan penuh terhadap layanan cloud. Keunggulan dalam hal kecepatan, privasi, akses offline, dan fleksibilitas menjadikan Local LLM semakin menarik untuk kebutuhan pribadi maupun profesional. Perkembangan perangkat keras serta teknik optimasi membuat penggunaan AI lokal semakin mudah tanpa selalu bergantung pada perangkat kelas tertinggi. Dengan perkembangan yang terus berlanjut, TEKNOLOGI Local LLM berpotensi menjadi bagian penting dari ekosistem AI masa depan sekaligus memberi pengguna lebih banyak pilihan mengenai bagaimana dan di mana kecerdasan buatan dijalankan.