Amazon Luncurkan TorchNeuron agar Kode PyTorch Lebih Mudah Berjalan di Chip Trainium
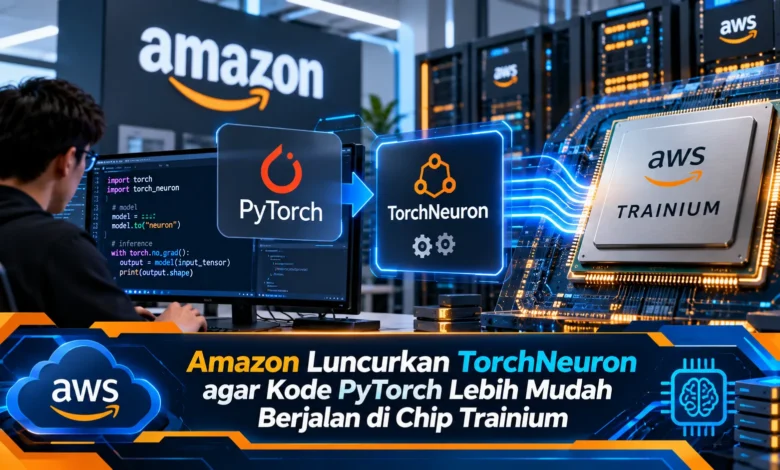
Amazon Web Services (AWS) resmi meluncurkan TorchNeuron dalam versi public beta pada 20 Oktober 2026 sebagai langkah penting untuk menyederhanakan pengembangan kecerdasan buatan. Teknologi open source ini memungkinkan pengembang menjalankan kode PyTorch secara lebih langsung pada chip AWS Trainium tanpa perlu melakukan penulisan ulang aplikasi secara menyeluruh. Kehadiran TorchNeuron memberikan pilihan baru bagi peneliti, perusahaan teknologi, dan pengembang model AI yang membutuhkan infrastruktur komputasi berkinerja tinggi. Melalui integrasi dengan PyTorch, Amazon berupaya mengurangi hambatan penggunaan akselerator AI sekaligus memperluas fleksibilitas pengembangan model machine learning di lingkungan cloud.
Inovasi TorchNeuron untuk Mempermudah Komputasi Kecerdasan Buatan
AWS menghadirkan TorchNeuron sebagai backend PyTorch berbasis open source yang bertujuan menyederhanakan pengoperasian aplikasi machine learning di akselerator Trainium. Sebelumnya, adaptasi aplikasi pembelajaran mesin menuju akselerator baru sering memerlukan penyesuaian perangkat lunak. Tantangan seperti ini berpotensi memperpanjang waktu pengembangan. Melalui peluncuran framework tersebut, pengembang dapat memanfaatkan kode PyTorch yang sudah tersedia melalui mekanisme kompatibilitas PyTorch native. Dukungan tersebut memberikan nilai tambah bagi ekosistem pengembangan AI.
AWS menyediakan TorchNeuron dalam bentuk rilis beta terbuka untuk komunitas pengembang. Untuk versi public beta tersebut, kompatibilitas utamanya tersedia pada Amazon EC2 Trainium2 dan Trainium3. Kedua generasi akselerator tersebut ditujukan bagi beban kerja kecerdasan buatan yang membutuhkan kapasitas pemrosesan tinggi. Amazon juga menempatkan TorchNeuron sebagai komponen dalam lingkungan pengembangan AWS Neuron. Keterpaduan sistem tersebut menyediakan dukungan bagi eksperimen pembelajaran mesin yang lebih terintegrasi. Namun demikian, pengguna masih harus memeriksa kompatibilitas aplikasinya sebelum menjalankannya pada lingkungan berskala besar.

Cara Kerja TorchNeuron dalam Menjalankan PyTorch pada AWS Trainium
Dari sisi arsitektur, TorchNeuron memanfaatkan sistem ekstensi perangkat PyTorch yang dikenal sebagai PrivateUse1. Pendekatan tersebut memungkinkan Trainium dikenali sebagai perangkat komputasi tanpa mewajibkan penggunaan API perangkat keras yang sepenuhnya terpisah. Sebagai contoh, kode yang sebelumnya menempatkan tensor pada CUDA dapat mengubah penempatan perangkat menjadi neuron. Penyesuaian sederhana ini dapat dilakukan dengan mengubah tujuan tensor dari CUDA ke neuron. Melalui pendekatan tersebut, sebagian besar alur pemrograman standar tetap dapat dipertahankan. Walaupun begitu, dukungan seluruh komponen model tidak boleh langsung diasumsikan.
Backend tersebut menghadirkan mode pemrosesan eager yang membantu pengembang melakukan eksperimen secara interaktif. Mode ini mempermudah eksperimen awal karena peneliti bisa mengevaluasi hasil perhitungan langsung. Di luar pemrosesan langsung, TorchNeuron dapat memanfaatkan kompilasi melalui torch.compile untuk menghasilkan pemrosesan berbasis grafik komputasi. Pada penggunaan torch.compile, grafik komputasi dapat dioptimalkan sebelum diproses oleh perangkat Trainium. Kombinasi kedua mode tersebut membantu menyeimbangkan kemudahan eksperimen dan performa. Pengembang dapat memilih pendekatan pemrosesan yang paling relevan.
Cara TorchNeuron Mendukung Pengoptimalan Komputasi Trainium
Tidak hanya menyediakan dukungan backend native, TorchNeuron juga terhubung dengan Neuron Kernel Interface atau NKI. Antarmuka pemrograman ini memberikan kontrol lebih rinci terhadap pemrosesan tertentu pada arsitektur perangkat keras Trainium. Dalam pengembangan model besar, operator standar tidak selalu memberikan performa paling optimal. Melalui NKI, insinyur performa memiliki kesempatan membuat implementasi operasi yang sesuai kebutuhan. Untuk contoh penerapan, bagian perhitungan matriks dapat dianalisis untuk menemukan hambatan performa. Meski demikian, keuntungan performa harus diukur melalui pengujian.
Untuk membantu proses evaluasi, AWS menyediakan Neuron Explorer yang mendukung pemeriksaan profil eksekusi. Melalui integrasi dengan torch.profiler, peneliti berkesempatan menganalisis perilaku model hingga asal instruksi yang dijalankan. Kemampuan ini membantu menemukan bagian yang memperlambat pemrosesan. Sebagai ilustrasi, apabila proses pelatihan berjalan lebih lambat dari harapan, tim teknis bisa memeriksa operasi yang membutuhkan waktu besar. Temuan dari proses profiling kemudian digunakan untuk memprioritaskan peningkatan performa. Dengan demikian, TorchNeuron menawarkan jalur dari eksperimen menuju penyempurnaan kinerja.
Keunggulan Integrasi PyTorch dengan AWS Trainium
Nilai utama dari kehadiran TorchNeuron adalah berkurangnya kompleksitas perpindahan akselerator. Pada proyek machine learning, tim biasanya menghabiskan banyak waktu untuk memastikan kompatibilitas model. Jika penggunaan akselerator baru menuntut banyak perubahan kode, biaya pengembangan dapat meningkat. Amazon melalui TorchNeuron mencoba menyederhanakan kompleksitas migrasi tersebut dengan menghubungkan API PyTorch langsung dengan akselerator. Melalui pendekatan tersebut, tim dapat lebih fokus pada eksperimen model. Walaupun demikian, manfaat nyata perlu dievaluasi berdasarkan model dan kebutuhan komputasi.
Dalam lingkungan bisnis berbasis kecerdasan buatan, TorchNeuron memperluas opsi komputasi model melalui AWS Trainium. Ketersediaan akselerator tersebut memungkinkan organisasi mengevaluasi performa komputasi berbagai beban kerja. Dalam skenario penggunaan nyata, efisiensi penggunaan akselerator sangat diperhatikan. Pengambil keputusan harus mengevaluasi harga penggunaan instance, kebutuhan memori, serta biaya pengelolaan sistem. Dengan akses PyTorch yang lebih mudah, evaluasi penggunaan Trainium dapat dilakukan lebih cepat. Walaupun Amazon menekankan efisiensi Trainium, biaya operasional perlu dibandingkan menggunakan data penggunaan nyata.
Peluang Pemanfaatan TorchNeuron dalam Pengembangan Model AI Modern
Pengembangan backend PyTorch native menyediakan fondasi bagi beragam pekerjaan machine learning. Salah satu bidang penting adalah pemrosesan model AI generatif berbasis teks. Model seperti ini memerlukan pemrosesan matriks yang kompleks. Integrasi baru ini memungkinkan penggunaan mekanisme distributed training standar seperti DistributedDataParallel, FullyShardedDataParallel, dan DTensor. Berkat integrasi tersebut, pengembang dapat memanfaatkan pendekatan pelatihan paralel pada infrastruktur komputasi berskala besar. Namun demikian, efisiensi penskalaan harus diperiksa secara langsung.
Selain model bahasa, TorchNeuron berpotensi digunakan dalam penelitian sistem pembelajaran mesin untuk data multimedia. Perusahaan teknologi yang memanfaatkan pustaka Hugging Face berpeluang mencoba backend TorchNeuron melalui dukungan perangkat lunak yang terus dikembangkan. Potensi penerapan ini dapat dimanfaatkan untuk berbagai kebutuhan seperti pemrosesan suara dan bahasa, pemodelan data kompleks, serta eksperimen ilmiah berbasis AI. Walaupun potensi penerapannya luas, tingkat kompatibilitas tidak selalu identik pada semua aplikasi. Dengan mempertimbangkan hal tersebut, peneliti sebaiknya membandingkan keluaran model sebelum memindahkan layanan ke produksi.
Rangkuman Manfaat TorchNeuron untuk Pengguna PyTorch dan AWS Trainium
Pengembangan TorchNeuron dalam ekosistem Trainium menunjukkan perkembangan integrasi framework machine learning dan hardware khusus. Dengan menghadirkan integrasi API PyTorch, pengembang dapat mencoba AWS Trainium dengan penyesuaian kode yang lebih sedikit. Fitur eager execution, torch.compile, serta Neuron Kernel Interface mendukung berbagai kebutuhan komputasi model. Meski saat ini tersedia sebagai beta publik, TorchNeuron menjadi alternatif penting bagi pengembangan komputasi kecerdasan buatan. Di tengah perkembangan TEKNOLOGI yang semakin pesat, kompatibilitas software dan hardware semakin menentukan efisiensi. Dari sudut pandang Anda, apakah kemudahan kompatibilitas akan menjadi faktor utama dalam persaingan akselerator kecerdasan buatan? Mari sampaikan pandangan tentang perkembangan TorchNeuron.